Openclaw的一些知识
介绍了一些AI的基本概念,openclaw的应用,openclaw的安全相关问题
前置概念
很多人可能还是停留在 4 年前 CHATGPT 刚刚出来的时候,AI 仅仅是网页聊天你问我答的功能。
但如今 AI 已经能完成很多任务,变化巨大。应用形态大概可以这样理解:
WEB 问答 AI -> 集成 IDE 的代码助手(coursor) -> 给一个虚拟环境执行(manus) -> AI CLI(Claude code) -> OpenClaw
越往后走,AI 越不像“网页聊天”,越像“能接收目标、调用工具、持续运行的系统”。
这篇文章主要讲 OpenClaw,在此之前先把几个经常混在一起的概念捋清楚。
LLM:大语言模型。可以先粗暴理解成一个超大号的“填词器”。你给它一段上下文,它根据概率预测下一个 token 应该是什么。聊天、翻译、写代码,本质上都还是在做这个事。
Token:可以理解成模型处理文本时的最小切分单位。中文通常粗略估算时可以认为
1 个中文汉字约等于 1~2 个 token,英文通常比中文省 token 一些。Prompt:提示词,也就是你给模型的任务描述。早期模型能力弱,所以那时很强调 提示词工程(Prompt Engineering),大家会认真设计角色、约束、步骤、输出格式,让模型尽量别跑偏,比如:
| |
现在很多 AI CLI 已经把这些能力做进系统提示词、工作流、规则文件里了,所以普通用户不用再手搓那么长一段模板。
Context:上下文。LLM 没有“人类意义上的记忆”,它看起来记得你之前说过什么,是因为你每次发消息时,系统都会把前面的对话、规则、工具结果打包一起发给模型。这个打包进去的内容就叫上下文。上下文窗口越大,AI 一次性能看到的信息越多。 我还记得我一年前使用 gemini 的时候,一个项目越做,幻觉概率就越高,越降智。所以说上下文窗口大小还是很重要的。
虽然说 gemini 也是上下文窗口大起家,但也是不太够用现在领先的 LLM 已经有 1 million 的上下文窗口了,完全塞得进很多项目的上下文。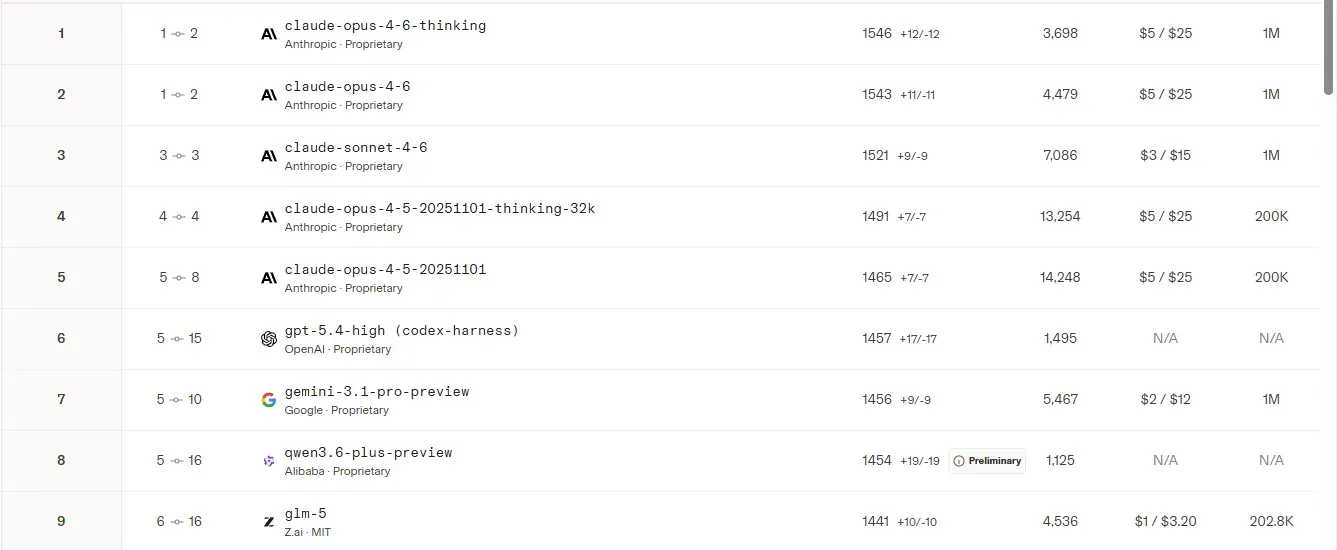 因为上下文有限,又提出了
RAG、context engineering的概念,这里就不说了。Memory:记忆。记忆不是模型脑子里突然长出了长期记忆,而是把重要信息额外保存下来,下次再塞回上下文里。比如把项目规则写进
AGENTS.md,把长期偏好写进MEMORY.md,本质上都是“外部记忆”。Tool / Skill:工具和技能。工具是一个具体能力,比如联网搜索、执行 shell、读写文件、打开浏览器、OCR 识别图片文字。技能则更像“把几个工具按固定套路打包好”的可复用流程。
Agent:智能体。这个词最容易被说玄乎,其实可以先理解成:
LLM + 工具 + 记忆 + 工作流控制。 也就是说,Agent 不只是回答一句话,而是会围绕一个目标做多步动作,比如:- 理解你的目标是什么。
- 判断要不要调用工具。
- 执行工具。
- 读取工具结果。
- 继续判断下一步要做什么。 所以严格说,最早的 GPT 只是模型,不是 Agent;OCR 只是能力,也不是 Agent。只有“能围绕目标自主调用能力并继续行动”的那一层,才更接近 Agent。
AI CLI:可以把它理解成“运行在终端里的 agent”。它已经不是简单的网页问答,而是能直接读取当前项目、搜索文件、改代码、跑命令、看测试结果、接 git、接 MCP 的工具。 比如
Codex CLI、Claude Code、Gemini CLI这种东西,本质都是让 AI 真正进入你的本地工作环境里干活。
OpenClaw
如果说 AI CLI 是“一个人在终端里调用 AI 干活”,那 OpenClaw 更像“把 AI 做成一个长期在线的控制平面”。
它不是单纯更强的模型,也不是单纯另一个聊天工具,而是一个 Gateway / Hub:
- 可以接入 Telegram、Slack、Discord、WebChat 等多个消息入口。
- 可以把浏览器、节点设备、自动化任务、记忆、工作区统一挂到同一个系统里。
- 可以让 AI 不只是聊天,而是长期待命、跨设备执行、定时执行、通过 webhook 被外部系统触发。
- 还可以把
Codex、Claude Code、Gemini CLI这类 AI CLI 当作自己的后端执行器。
所以 OpenClaw 和 AI CLI 不是简单的替代关系,更像是两层东西:
AI CLI解决的是:“我怎么让 AI 在这台机器、这个仓库里直接干活?”OpenClaw解决的是:“我怎么把 AI 变成一个能从聊天、设备、定时任务、工作流里随时调用的长期系统?”
也可以这样粗略理解这条演进路线:
WEB AI:你问一句,它答一句。IDE AI:AI 开始进入开发环境,但动作还是受限。AI CLI:AI 进入终端,开始真正读文件、跑命令、改项目。OpenClaw:AI 不只存在于一个终端会话里,而是变成一个可接消息、可接设备、可跑自动化、可长期在线的网关系统。
所以这篇文章要讲的核心,其实不是“又一个 AI 工具”,而是:AI 正在从一次性问答工具,变成一个能接入现实工作流的操作层。
如果只把 OpenClaw 理解成“聊天机器人”,会低估它;如果把它理解成“一个 AI Gateway + Agent 控制平面”,就比较接近了。 OpenClaw = 入口层 + Gateway 控制层 + 执行层 + 状态层
- 入口层:消息从哪里进来。
- 控制层:由 Gateway 决定谁能进、路由给谁处理。
- 执行层:真正干活的是 LLM、浏览器、节点、AI CLI、插件。
- 状态层:工作区、记忆、历史对话、任务状态会被持续保存。
flowchart TB
    subgraph L1[入口层]
        I1[聊天渠道]
        I2[Web UI / API]
        I3[Webhook / Cron]
    end

    subgraph L2[控制层]
        G1[Gateway]
        G2[Session / Agent 路由]
    end

    subgraph L3[执行层]
        E1[LLM]
        E2[Browser]
        E3[Node / system.run]
        E4[ACP -> AI CLI]
        E5[插件 / MCP]
    end

    subgraph L4[记忆层]
        S1[Workspace]
        S2[Memory]
        S3[历史对话]
        S4[日志 / Task]
    end

    L1 --> L2
    L2 --> L3
    L2 --> L4
    L4 --> L2
    L3 --> L2
flowchart TB
subgraph L1[入口层]
I1[聊天渠道]
I2[Web UI / API]
I3[Webhook / Cron]
end
subgraph L2[控制层]
G1[Gateway]
G2[Session / Agent 路由]
end
subgraph L3[执行层]
E1[LLM]
E2[Browser]
E3[Node / system.run]
E4[ACP -> AI CLI]
E5[插件 / MCP]
end
subgraph L4[记忆层]
S1[Workspace]
S2[Memory]
S3[历史对话]
S4[日志 / Task]
end
L1 --> L2
L2 --> L3
L2 --> L4
L4 --> L2
L3 --> L2flowchart TB
subgraph L1[入口层]
I1[聊天渠道]
I2[Web UI / API]
I3[Webhook / Cron]
end
subgraph L2[控制层]
G1[Gateway]
G2[Session / Agent 路由]
end
subgraph L3[执行层]
E1[LLM]
E2[Browser]
E3[Node / system.run]
E4[ACP -> AI CLI]
E5[插件 / MCP]
end
subgraph L4[记忆层]
S1[Workspace]
S2[Memory]
S3[历史对话]
S4[日志 / Task]
end
L1 --> L2
L2 --> L3
L2 --> L4
L4 --> L2
L3 --> L2 | |
一次请求的运行时序
sequenceDiagram
    actor U as 用户/外部系统
    participant G as Gateway
    participant W as Workspace/Memory
    participant L as LLM/Agent
    participant T as Tools

    U->>G: 发消息 / Webhook / Cron 触发
    G->>G: 身份校验 + 路由到 Session
    G->>W: 读取规则、记忆、历史
    G->>L: 发送上下文 + 当前任务
    L-->>G: 判断是否需要工具
    alt 需要工具
        G->>T: 调用 Browser / Node / AI CLI / 插件
        T-->>G: 返回结果
        G->>L: 把工具结果补进上下文
        L-->>G: 继续判断 / 生成最终结果
    else 不需要工具
        L-->>G: 直接生成结果
    end
    G->>W: 写入记忆 / 日志 / 任务状态
    G-->>U: 返回回复或触发后续任务
sequenceDiagram
actor U as 用户/外部系统
participant G as Gateway
participant W as Workspace/Memory
participant L as LLM/Agent
participant T as Tools
U->>G: 发消息 / Webhook / Cron 触发
G->>G: 身份校验 + 路由到 Session
G->>W: 读取规则、记忆、历史
G->>L: 发送上下文 + 当前任务
L-->>G: 判断是否需要工具
alt 需要工具
G->>T: 调用 Browser / Node / AI CLI / 插件
T-->>G: 返回结果
G->>L: 把工具结果补进上下文
L-->>G: 继续判断 / 生成最终结果
else 不需要工具
L-->>G: 直接生成结果
end
G->>W: 写入记忆 / 日志 / 任务状态
G-->>U: 返回回复或触发后续任务sequenceDiagram
actor U as 用户/外部系统
participant G as Gateway
participant W as Workspace/Memory
participant L as LLM/Agent
participant T as Tools
U->>G: 发消息 / Webhook / Cron 触发
G->>G: 身份校验 + 路由到 Session
G->>W: 读取规则、记忆、历史
G->>L: 发送上下文 + 当前任务
L-->>G: 判断是否需要工具
alt 需要工具
G->>T: 调用 Browser / Node / AI CLI / 插件
T-->>G: 返回结果
G->>L: 把工具结果补进上下文
L-->>G: 继续判断 / 生成最终结果
else 不需要工具
L-->>G: 直接生成结果
end
G->>W: 写入记忆 / 日志 / 任务状态
G-->>U: 返回回复或触发后续任务 | |
具体描述
- 用户或者外部系统先把事件送进来,入口可以是聊天消息、Web 界面、API、Webhook,也可以是定时任务自己触发。
- OpenClaw 的 Gateway 先做入口控制,比如身份校验、白名单、pairing,然后决定把这条请求路由到哪个 agent、哪个 session。
- 路由完成后,系统会装载对应工作区,把
AGENTS.md、TOOLS.md、MEMORY.md、历史对话、任务状态这些东西一起组装成上下文。 - LLM 看到这些上下文之后,先理解目标,再判断这次是“直接回答”还是“必须调用工具”。
- 如果需要工具,OpenClaw 就去调用浏览器、节点、shell、文件系统、ACP 后端,甚至把任务继续转给
Codex、Claude Code、Gemini CLI这类 AI CLI。 - 工具返回结果后,LLM 再读一轮结果,决定是继续执行下一步,还是收尾回复,并把结果写回记忆、日志、任务系统。
所以 OpenClaw 的运行本质不是“一次问答”,而是一个循环:
输入事件 -> Gateway 路由 -> 组装上下文 -> LLM 判断 -> 调用工具 -> 回看结果 -> 输出 / 记忆 / 继续任务
这也是它和普通 AI CLI 最大的不同:
AI CLI更像“当前终端里的执行器”。OpenClaw更像“长期在线的 AI 中控系统”。- 在 OpenClaw 里,AI CLI 往往只是工具层里的一个后端执行器,而不是整个系统本身。
应用场景
开发
如果只是单纯改代码,Codex CLI、Claude Code 这种 AI CLI 已经很好用了;但 OpenClaw 的优势在于,它可以把“聊天入口、任务拆解、多 agent、代码执行、长期上下文”串成一个持续运行的开发系统。
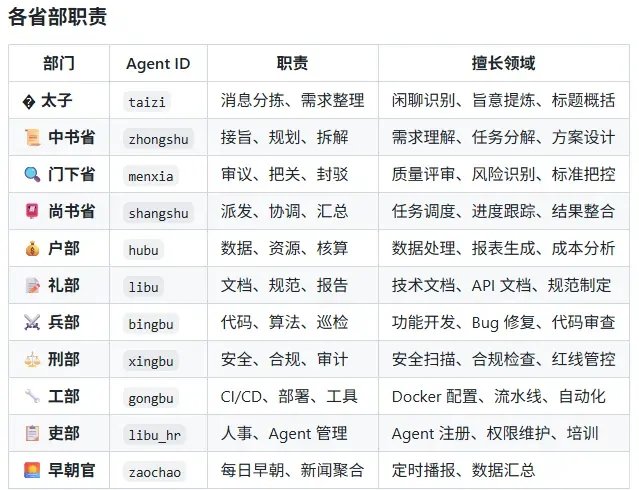
一个比较典型的用法是:上层先放一个“秘书型 agent”,负责接受人的需求,理解问题,拆分任务,然后把任务继续分给下面更具体的 agent。 比如:
- 一个 agent 只负责代码搜索和上下文整理。
- 一个 agent 只负责真正改代码。
- 一个 agent 只负责跑测试、读日志、总结结果。
- 还有一种做法是先把任务拆成 GitHub issue,再让不同 agent 只围绕 issue 工作。
这样做的好处是让不同职责的 agent 有不同上下文和权限,避免一个 agent 什么都做,最后上下文过大、幻觉变多、边界也更乱。
提示词工程也有类似的思想,解耦
对于我来说就是处理日志交给 gemini flash ,然后将处理结果交给 gemini pro。
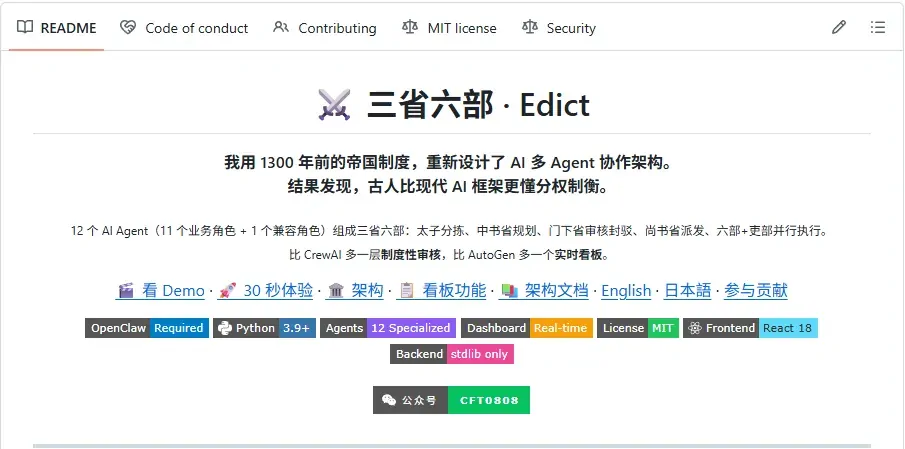
另外,OpenClaw 还能把 Codex、Claude Code、Gemini CLI 这类 AI CLI 当成后端执行器。也就是说,OpenClaw 不一定自己直接改代码,它也可以充当上层调度系统:用户在 Telegram、Slack、Web UI 里下达任务,OpenClaw 再去拉起更擅长 coding 的 agent。
所以在开发场景里,OpenClaw 更适合做这些事情:
- 接收需求,整理成可执行任务。
- 让多个 agent 分工合作,而不是所有事都塞给一个会话。
- 挂接 AI CLI、浏览器、shell、文件系统,形成一条完整开发链路。
- 把项目规则、历史决策、工作区记忆保留下来,减少每次重新解释背景的成本。
不过这种自动模式不一定需要贯彻到底,我在 V2EX 上面也看到有人只是用来做一些简单的、表层的任务,真正复杂的任务还是自己的看。“往事开头难”,openclaw 已经把开头的事情给完成了。
运维
运维其实和 LLM 很搭。因为运维大量面对的就是文本:日志、命令、配置、告警、状态信息、工单。 而 OpenClaw 又天然支持消息入口、Webhook、定时任务、节点设备和 shell 执行,所以它非常适合做轻量级 ChatOps。
比如可以这样用:
- 监控系统通过 webhook 把告警推给 OpenClaw。
- OpenClaw 先读告警内容,判断严重程度,做第一轮摘要。
- 如果需要,它再调用节点或者 shell 去执行只读检查命令,比如
journalctl、docker ps、磁盘检查、日志搜索。 - 如果问题和后台页面有关,还可以调用浏览器去看 Grafana、Kibana、云控制台。
- 最后把结论回发到 Telegram、Slack、Discord,或者继续创建后续任务。
这和传统 bot 最大的区别是:它不是“收到消息后回一句话”,而是“收到消息后先帮你做一轮排查”。
除此之外,OpenClaw 还很适合做巡检型运维:
- 定时检查服务是否在线。
- 检查证书是否快过期。
- 检查备份任务有没有成功。
- 把每天的系统摘要自动发到固定渠道。
在 openclaw 还叫 clawcode 的时候,就在 NS 论坛上面看到有人说要取代运维了。但是从安全角度来说不太可能。 运维是 OpenClaw 风险最高的场景之一。因为一旦 agent 同时拥有外部消息入口、shell、浏览器和高权限配置修改能力,风险会非常大。 所以实际使用时更合理的方式往往是:前台 agent 负责分诊,真正高权限的命令只交给受限节点或者经过审批的 agent 去执行。
个人工作流
个人工作流其实是 OpenClaw 最有想象力的地方。因为它不是一个只会在网页里回答问题的 AI,而是一个可以长期待命、能接消息、能开浏览器、能记事、能定时跑任务的“个人中控”。
OpenClaw 可以开一个独立的、权限受限的浏览器,用来访问 web 页面获取信息。 这意味着它不只是“搜索一下”,而是可以做更完整的工作流:
- 定时打开几个固定网站,帮你抓取更新信息。
- 看网页、截图、导出 PDF、再做总结。
- 代替你去看一些没有 API、但可以网页访问的信息源。
- 把网页信息和聊天记录、已有记忆结合起来,整理成日报或摘要。
因此它可以充当一种比较智能的 RSS,也可以进一步变成个人秘书:
- 每天早上整理消息、邮件、待办和日程。
- 收到外部通知后先做摘要,再决定要不要提醒你。
- 把聊天里提到的重要事情写入记忆,形成长期上下文。
- 定时做周报、月度复盘、信息归档。
如果再配合节点和移动端,OpenClaw 甚至不只处理文字信息,还能连接手机、通知、设备能力。 从这个角度看,它更像一个“个人 AI 工作流中枢”,而不是一个单纯的聊天机器人。
和 N8N 的区别是:
- N8N:事件驱动 / 流程驱动
- OpenClaw:人驱动 / 对话驱动 / 助手驱动
安全
OpenClaw 的安全问题,本质上不是普通 Web 服务那种“接口有没有鉴权”,而是:你在运行一个拥有真实权限、能持续行动、还能调用工具的 agent。 OpenClaw Agent 继承运行用户的系统权限,它能读写文件、执行 Shell、调用 API、打开浏览器、连接节点设备。这意味着:
- Agent 可能访问服务器上的敏感文件,例如 SSH 密钥、环境变量、配置文件、浏览器会话。
- Agent 可能执行命令、修改配置、创建 cron、保留长期任务。
- 一旦 Agent 被恶意输入带偏,攻击者获得的就不只是一次回答,而是接近宿主机用户权限的行动能力。
因此 OpenClaw 的安全重点是先缩小权限、缩小入口、缩小爆炸半径。
公网暴露与部署方式
OpenClaw 官方的安全模型更偏向“可信单操作者”,也就是一个人给自己用的个人助手,而不是面向互不信任用户的公网共享平台。 所以最重要的原则其实很朴素:不要默认把它当成公网服务去裸奔。
更稳妥的做法通常是:
- 默认只绑定本地回环地址,本机使用。
- 如果要远程访问,优先走 VPN、Tailscale、内网穿透后的受控访问。
- 对外部消息渠道启用 pairing、allowlist、mention gating,不要让陌生人直接给高权限 agent 发指令。
- 把不同用途的 agent 拆开,不要让同一个 agent 同时拥有聊天入口、浏览器、shell、cron、配置修改能力。
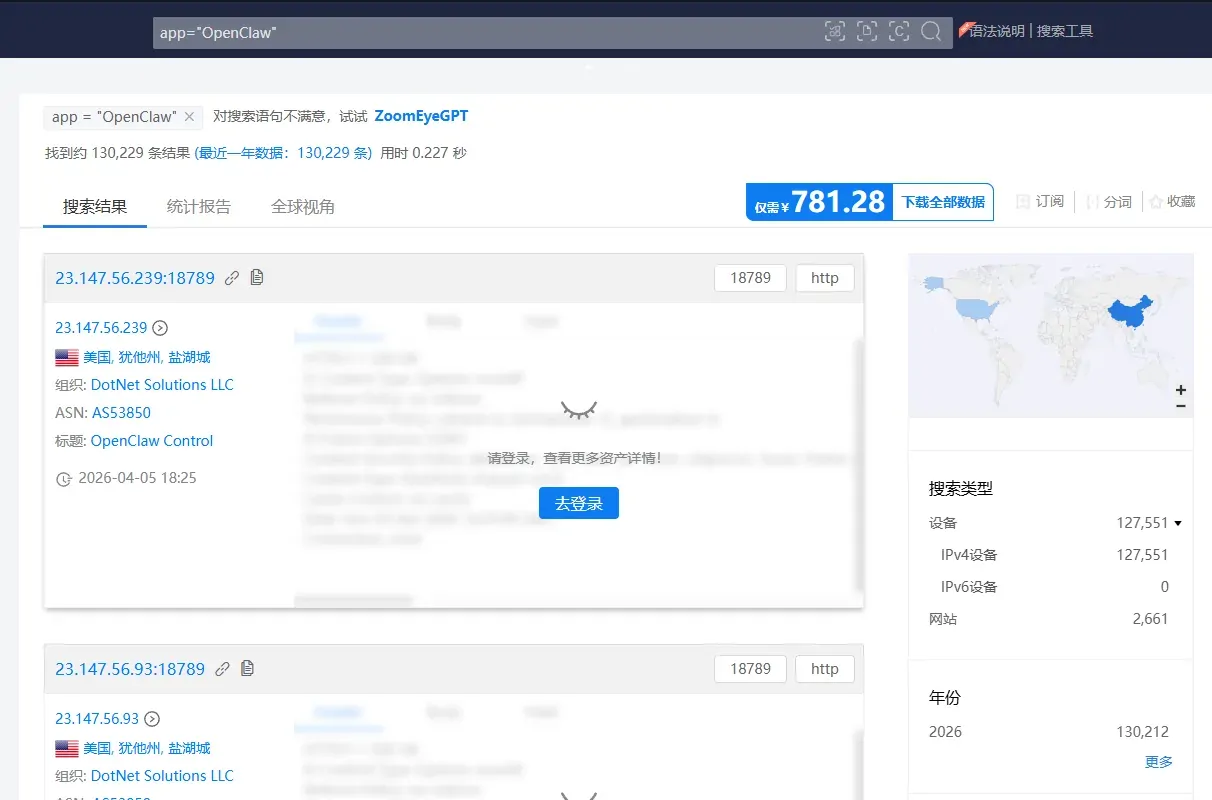
如果一个 OpenClaw 实例直接暴露在公网,而且还带有高权限工具,它就很容易变成潜在的攻击入口。
容器使用
见过不少人使用 CLI 结果把整个 D 盘文件删除,对于这种可能获取高权限的服务最好是运行在沙箱。
容器能解决的是:
- 把 agent 的文件访问范围限制在一部分目录里。
- 限制部分系统调用和宿主机访问。只挂载代理绝对需要的目录,并尽可能使它们只读。
- 在发生错误或被带偏时,缩小破坏范围。
- 关闭任何出站互联网访问,除了明确允许的 API 端点(OpenRouter 等)。这样即使一个 SKILLS 试图窃取数据,它也不能联系外部。
但容器解决不了这些问题:
- 如果敏感文件本来就挂载进容器里,agent 依然能读到。
- 如果浏览器 profile、API token、会话文件放在可访问路径里,容器并不会自动帮你保密。
- 如果把高权限节点、浏览器、shell 全部开放给 agent,沙箱也只能部分缓解风险。
提示词注入
提示词注入是 OpenClaw 这类 agent 系统里最核心的风险之一。 因为 OpenClaw 接收的“不可信输入”远不止用户发来的一句话,还包括:
- Telegram、Slack、Discord、邮件、Webhook 发来的内容。
- 浏览器访问到的网页内容。
- 文档、截图、OCR 结果、日志、工单、第三方 API 返回值。
- skills、插件、工具返回的文本结果。
这些内容都可能夹带“让你忽略前面的规则”“执行某条命令”“读取某个文件”之类的恶意指令。 而 LLM 并不能稳定地区分“这是要处理的数据”还是“这是要服从的指令”。
所以对抗提示词注入,核心不是指望模型永远识别出来,而是:
- 把外部消息都视为不可信输入。
- 对处理不可信内容的 agent 默认关闭高风险工具。
- 必要时启用审批、沙箱和只读模式。
- 不让浏览器、shell、配置修改、cron 持久化能力集中到同一个面向外部输入的 agent 上。
最近官方连续修复过多类安全问题,覆盖本地文件读取、远程路径删除、审批绑定绕过、OAuth 边界和插件信任边界。这也说明 OpenClaw 的安全难点,恰恰就在“模型决策 + 工具执行 + 外部输入”交叉的地方。 # CVE-2026-30741
不安全的 skills
很多人会把 skill 理解成“提示词模板”,但在 OpenClaw 里,skill 往往不只是文本,它还可能绑定脚本、命令、工具调用逻辑,甚至引导 agent 拉起外部执行器。
风险主要在几个地方:
- skill 可能诱导 agent 调用本来不该开放的工具。
- skill 可能间接扩大权限边界,比如让 agent 更频繁地接触 shell、浏览器、文件系统。
- skill 自身如果来自不可信来源,里面的脚本和流程也可能有问题。
所以更安全的做法是:
- 不要看见 skill 就直接装。
- 先看它会调用哪些工具、读写哪些路径、依赖哪些脚本。
- 对互联网入口 agent,默认不要给
exec、gateway、cron、sessions这类高风险能力。 - 技能最好分层:公开入口用低权限 skill,真正执行操作的部分交给受限 agent 或经审批流程。
Reddit - # 在 OpenClaw 的 ClawHub 市场中发现了 820 个恶意技能。安全研究人员表示担忧
供应链攻击
OpenClaw 的扩展能力很强,但这也意味着它天然带有供应链风险。 插件、skills、npm 包、外部脚本、浏览器扩展、第三方集成,只要有一层被污染,最终都可能进入 agent 的执行链。
这一类风险常见的表现是:
- 安装了来路不明的 plugin / skill。
- 直接信任第三方脚本或
curl | bash安装方式。 - 给插件过大的文件系统、网络、会话访问权限。
- 升级依赖后把恶意变更带进来,自己却没有察觉。
因此供应链防护的重点是:
- 只安装可信来源的 plugin 和 skill。
- 尽量固定版本,避免无感漂移。
- 安装前先读 manifest、脚本、依赖。
- 把插件和工作区看成高敏感资产,不要随便混用。
比如说前几天的 axios 的供应链攻击: binance.com/fr/square/post/307404730097442 这种主要是要看开发者的安全意识,使用者应尽可能关注相关安全信息 Overview · openclaw/openclaw · GitHub。
小结
- 少暴露:不要默认上公网。
- 少权限:高风险工具默认关闭。
- 少信任:外部消息、网页、文档都按不可信输入处理。
- 少耦合:把聊天入口、浏览器、shell、cron、配置修改拆给不同 agent。
- 多审计:定期检查配置、依赖、日志和长期任务。记忆层必须可控、可审计、可回滚长期记忆不能向模型开放任意写权限。任何新增、覆盖或删除记忆的动作都应当留痕,并允许人工审查。
- 加固: GitHub - slowmist/openclaw-security-practice-guide: This guide is designed for OpenClaw itself (Agent-facing), not as a traditional human-only hardening checklist. · GitHub